


לקרוא סקרי בחירות בלי לעבוד על עצמנו
חץ ירוק למעלה, שני מנדטים למטה, והמדינה כולה עוצרת את נשימתה מול עוד כותרת על "דרמה בסקרים". אנחנו נוטים להתייחס לגרפים על המסך כאל צילום ודאי של העתיד, אבל המציאות הסטטיסטית שברירית הרבה יותר. מההתרסקות ההיסטורית של הסוקרים בארה"ב ב-1936, דרך הלילה שבו הלכנו לישון עם פרס והתעוררנו עם נתניהו, ועד למנדטים שלמים שנמחקים בגלל עשירית אחוז מתחת לאחוז החסימה - בואו אל מאחורי הקלעים של תעשיית הסקרים. רגע לפני שאנחנו טובעים שוב בים המספרים של בחירות 2026, הנה כל מה שמסתתר מאחורי ההבטחה של "טעות הדגימה", ולמה השאלה החשובה ביותר לגבי כל סקר היא לא מי מוביל, אלא מה היה צריך לקרות כדי שהמספר הזה בכלל יופיע שם.
בלילה שבין 29 ל-30 במאי 1996 כמעט אף אחד בישראל לא הלך לישון רגוע. זו הייתה מערכת הבחירות הראשונה שבה בחרו הישראלים ישירות את ראש הממשלה. יצחק רבין נרצח פחות משבעה חודשים קודם לכן. שמעון פרס התמודד מול בנימין נתניהו, והמדינה כולה המתינה בעשר בלילה לרגע שכבר הפך אז לטקס לאומי: תוצאות המדגם. שני הערוצים הציגו כמעט אותה תמונה. בערוץ הראשון ובערוץ 2 קיבל פרס מעט יותר מ-50 אחוז במדגמים. קמיל פוקס, שערך את מדגם הערוץ הראשון, סיפר שנים אחר כך שמבחינתו התוצאה הייתה למעשה "צמוד מכדי להכריע", ורק בלחץ לתת תחזית ניסח אותה כ"תיקו עם יתרון קל לפרס". מי שרצה לשמוע "פרס ניצח" שמע את זה, והיו שכבר חגגו.
בבוקר כבר הייתה תשובה אחרת.
נתניהו קיבל 1,501,023 קולות. פרס קיבל 1,471,566. ההפרש היה 29,457 קולות מתוך קרוב לשלושה מיליון קולות כשרים לראשות הממשלה: 50.49 אחוז מול 49.51. פחות מאחוז אחד. המשפט שנשאר בזיכרון הישראלי היה כמעט טוב מכדי להיות אמיתי: הלכנו לישון עם פרס והתעוררנו עם נתניהו.
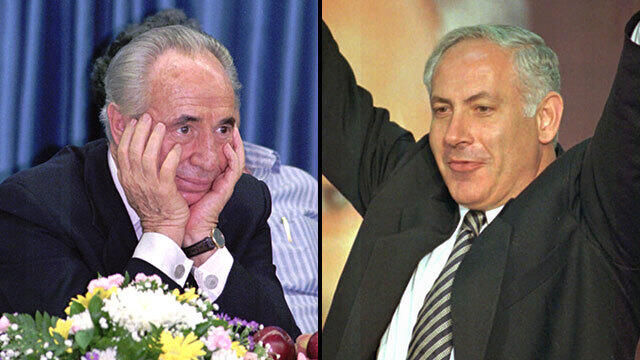
קל לקחת את הלילה הזה כהוכחה לכך שסקרים אינם שווים דבר. אבל זו דווקא המסקנה הפחות מעניינת. בלילה ההוא לא קרס המדע הסטטיסטי. ההפרש האמיתי היה זעיר, וסטייה קטנה מאד בין קלפיות המדגם לבין כלל המצביעים הספיקה כדי להפוך את זהות המנצח.
וזה אולי הדבר הראשון שצריך לזכור עכשיו, כשישראל שוב עמוק בתוך מערכת בחירות והמסכים מתמלאים כמעט מדי ערב במספרים, מנדטים, חצים אדומים וירוקים, גושים ומפלגות שנכנסות ויוצאות מהכנסת. סקר אינו צילום של העתיד. הוא אפילו לא באמת צילום של הקלפי. הוא ניסיון להעריך מה חושבת אוכלוסייה של מיליוני בני אדם ברגע מסוים, באמצעות כמה מאות מהם, ואז להעביר את התוצאה דרך שורה של הנחות סטטיסטיות.
הבחירות לכנסת ה-26 קבועות ל-27 באוקטובר 2026. קצת יותר מחודש לפני כן, ישראל כבר חיה במציאות שבה שינוי של שני מנדטים הופך לכותרת ראשית, ירידה של מפלגה אל מתחת לאחוז החסימה משנה מיד את חישובי הגושים, וסקרים שמתפרסמים כמעט באותו שבוע מציגים מפות פוליטיות שונות באופן דרמטי.
כדי להבין מה המספרים האלה באמת אומרים, כדאי לחזור כמעט מאה שנה אחורה, אל אחת הטעויות המפוארות בתולדות הסקרים.
ב-1936 היה השבועון האמריקאי ליטררי דייג'סט (The Literary Digest) מוסד בעל מעמד כמעט מלכותי בחיזוי בחירות. לקראת המרוץ בין הנשיא פרנקלין דלאנו רוזוולט לבין המועמד הרפובליקני אלף לנדון, שלח המגזין כעשרה מיליון טפסי הצבעה, סדר גודל שאף מכון סקרים מודרני לא היה חולם עליו. כ-2.4 מיליון בני אדם החזירו תשובה. זה היה מדגם ענק, גדול פי אלפים מסקר בחירות טיפוסי היום.
והוא היה שגוי לחלוטין.
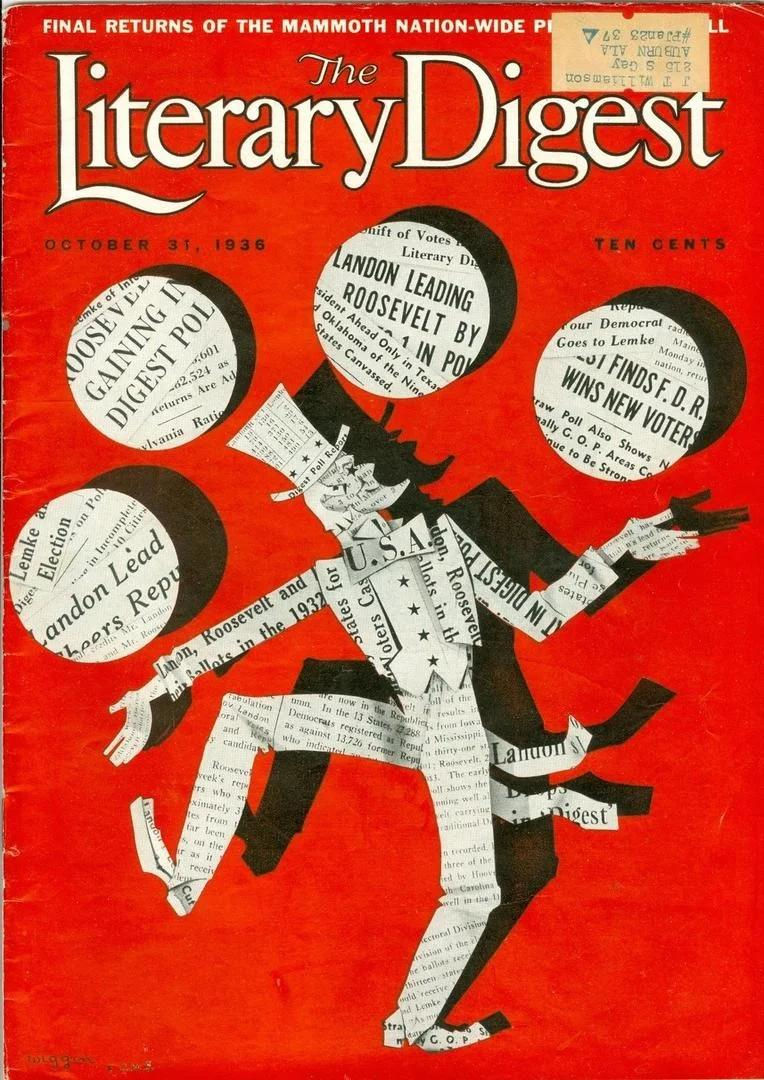
הדייג'סט חזה ניצחון ללנדון. רוזוולט ניצח בקלות, עם כמעט 61 אחוז מהקולות ו-523 מתוך 531 האלקטורים. במשך שנים סופר הסיפור בדרך פשוטה: המגזין בחר את הנמענים בין היתר מספרי טלפונים ומרשימות בעלי מכוניות, ולכן המדגם נטה לאמריקאים אמידים יותר בתקופת השפל הגדול. זה אכן יצר בעיית כיסוי, אבל מחקרים מאוחרים הראו שהסיפור המלא מעניין יותר. מדען המדינה פבריל סקווייר (Peverill Squire) חזר ב־1988 לנתונים מסקר גאלופ מ-1937 ומצא שהבעיה החריפה הייתה גם - ואולי בעיקר - מי בחר להשיב. תומכי לנדון החזירו את השאלונים בשיעור גבוה יותר. סקווייר מצא שהטיית הכיסוי לא פעלה לבדה. גם מי שבחר להשיב היה שונה ממי שלא השיב, ושתי ההטיות יחד יצרו את הכישלון. עד כדי כך, שאילו כל הנמענים היו מחזירים את השאלון, הדייג'סט היה לפחות מזהה נכון שרוזוולט ינצח.
באותן בחירות התפרסם אדם בשם ג'ורג' גאלופ (George Gallup). הוא השתמש במדגם קטן לאין שיעור, כחמישים אלף איש, והצליח לזהות שרוזוולט ינצח. האירוניה הייתה מושלמת: מיליוני תשובות הפסידו למדגם של עשרות אלפים. זו הייתה אחת ההמחשות הראשונות לעיקרון שרבים מתקשים לקבל גם היום. גודל האוכלוסייה כמעט אינו קובע כמה אנשים צריך כדי להעריך אותה. מה שקובע הרבה יותר הוא איך נבחר המדגם, ועד כמה הוא מייצג את האוכלוסייה שעליה רוצים ללמוד ממנו.
גאלופ הפך לכוכב. 12 שנה אחר כך הגיע תורו להתרסק.
ב-1948 התמודד הנשיא הארי טרומן מול תומאס דיואי. כמעט כל הסוקרים החשובים העריכו שדיואי ינצח. העיתון שיקגו דיילי טריביון היה בטוח מספיק כדי להדפיס את הכותרת שהפכה מאז לאחד הצילומים המפורסמים בהיסטוריה הפוליטית האמריקאית: DEWEY DEFEATS TRUMAN. בתמונה, טרומן המנצח מחזיק את העיתון מעל ראשו ומחייך.
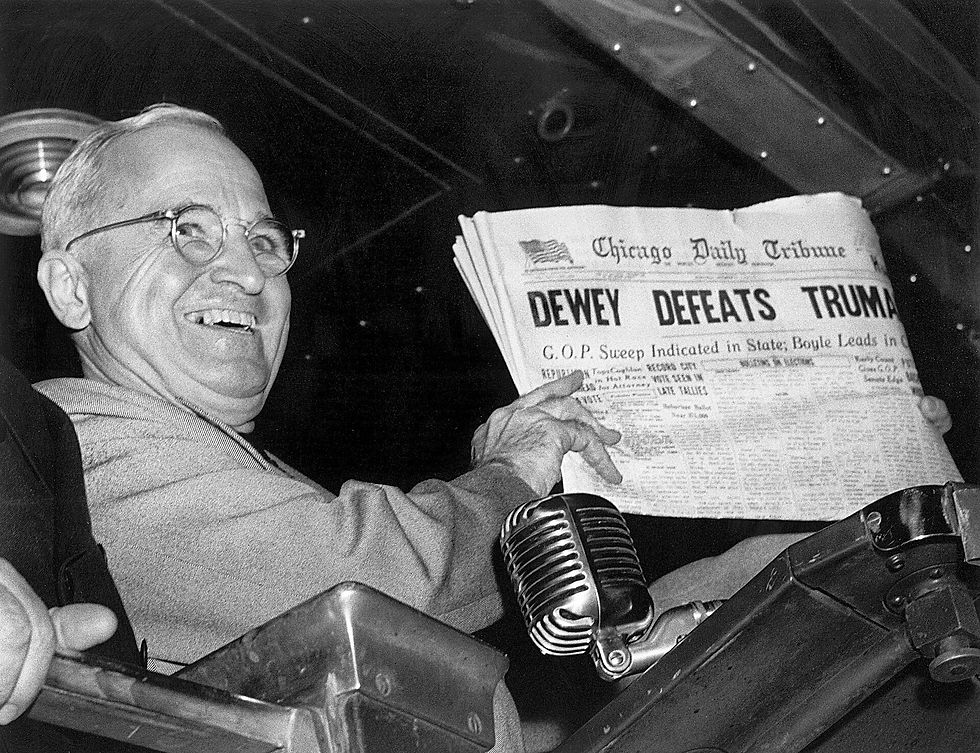
ההסבר המקובל לכישלון כולל שני רכיבים. הראשון פשוט להפליא: רוב הסוקרים הפסיקו לסקור באמצע אוקטובר, שבועיים-שלושה לפני הבחירות, והחמיצו תזוזה מאוחרת לטובת טרומן. השני עמוק יותר. באותן שנים עבדו הסוקרים בשיטת "מכסות": המראיין קיבל הוראה לראיין כך וכך גברים, כך וכך נשים, כך וכך בני גיל מסוים, ואת האנשים עצמם בחר בעצמו. מתברר שכשנותנים למראיינים לבחור, הם בוחרים, בלי כוונה, אנשים שקל יותר לגשת אליהם, ואלה נטו להיות רפובליקנים. בעקבות הכישלון החל עולם הסקרים להתרחק מדגימת מכסות ולעבור בהדרגה לדגימה הסתברותית, שבה לכל אדם יש סיכוי ידוע להיבחר, והמראיין לא מחליט מי.
כך התחיל דפוס שחוזר מאז שוב ושוב: הסקרים טועים, המקצוע מנתח את הטעות ומשנה את השיטה, ואז הבחירות הבאות מגלות בעיה חדשה.
כדי להבין למה, צריך לדבר על המספר שאולי גרם ליותר בלבול מכל מספר אחר בתחום: טעות הדגימה. בסקר פשוט של כאלף איש מופיע לעתים קרובות הנתון "טעות דגימה מרבית: כ-3 אחוזים, ברמת ביטחון של 95 אחוז". רובנו קוראים אותו כאילו פירושו שהסקר יכול לטעות בשלוש נקודות לכל היותר.
זה לא מה שהוא אומר.
טעות הדגימה מתארת רק את התנודתיות שנובעת מכך ששאלנו מדגם ולא את כל האוכלוסייה. אילו יכולנו לחזור שוב ושוב על אותו הליך דגימה בתנאים זהים, בערך 95 אחוז מהטווחים שהיינו מחשבים היו מכילים את הערך האמיתי. המספר הזה אינו יודע דבר על אנשים שלא ענו, על אנשים שלא יכלו להיכלל מלכתחילה, על ניסוח שאלה גרוע, על סוקר שהשפיע על הנשאל, על שקלול סטטיסטי לא נכון, על הנחה שגויה לגבי מי יגיע להצביע, על שינוי בדעת הקהל אחרי שהסקר נסגר, או על מצביע שפשוט לא אמר אמת.
במילים אחרות, המספר הקטן והנקי שמופיע בתחתית הגרף אינו מרווח הטעות הכולל של הסקר. קבוצת חוקרים מאוניברסיטאות סטנפורד וקולומביה וממעבדת המחקר של מיקרוסופט בדקה יותר מארבעת אלפים סקרים ב-608 מרוצים לסנאט, למושלים ולנשיאות בארצות הברית, ומצאה שהטעות הכוללת שנצפתה בפועל, כפי שנמדדה במחקר, הייתה בערך כפולה מזו שהייתה צפויה אילו טעות הדגימה המדווחת הייתה מקור השגיאה היחיד.
ויש עוד מלכודת. טעות הדגימה המודפסת מתייחסת לכל מפלגה בנפרד. אבל מה שמעניין את כולנו הוא הפער בין שתי מפלגות: מי מובילה ובכמה. מרכז המחקר האמריקאי פיו מזכיר שטווח הטעות של הפער הזה גדול בערך פי שניים מזה של מפלגה בודדת. כשמפלגה אחת מובילה בכמה נקודות אחוז בלבד - פער שמתורגם בכותרת לשלושה מנדטים - ייתכן שהפער בתמיכה עצמה כלל אינו מובהק סטטיסטית.
זה מסביר מדוע 500 בני אדם יכולים לפעמים לספר לנו משהו מדויק מאד על חמישה מיליון, ואיך הצליחו לטעות ב-1936 עם שני מיליון תשובות. השאלה אינה רק כמה נשאלו. השאלה היא מי הם, איך הגיעו אליהם, מי מהם הסכים לענות, איך תוקנו הפערים בין המדגם לבין האוכלוסייה, ואילו הנחות נכנסו לתוך המודל אחרי שהראיונות כבר הסתיימו.
הבריטים למדו את הלקח הזה בדרך הכואבת ב-2015. הסקרים האחרונים לפני הבחירות העמידו את השמרנים ואת הלייבור כמעט בדיוק באותה נקודה, סביב 34 אחוז כל אחת. בפועל קיבלו השמרנים כ-38 אחוז והלייבור כ-31 אחוז, ודייוויד קמרון זכה ברוב מוחלט שאיש לא צפה. כל חברות הסקרים הגדולות טעו באותו כיוון. דווקא משום שטעו יחד, אי אפשר היה להסביר את האירוע כרעש מקרי של מדגם בודד. מועצת הסקרים הבריטית (BPC) ואגודת חוקרי השווקים (MRS) הקימו יחד ועדת בדיקה עצמאית בראשות פרופ' פטריק סטרג'יס (Patrick Sturgis) מאוניברסיטת סאות'המפטון.
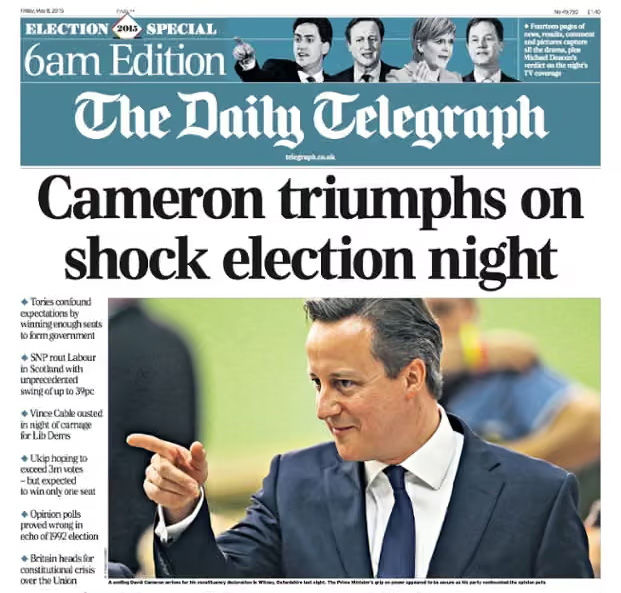
כמעט מיד עלה גם הסבר פסיכולוגי מפתה: "פקטור הטורי הביישן". אולי היו אנשים שתמכו בשמרנים אבל לא רצו לומר זאת לסוקר. הסברים מהסוג הזה חוזרים כמעט אחרי כל פספוס פוליטי גדול. בארצות הברית דיברו על "מצביע טראמפ הביישן", ובישראל נשמעה שוב ושוב הטענה שמצביעי ימין מסרבים להשתתף בסקרים. לפעמים התופעה אכן קיימת. הבעיה היא שקל מדי להשתמש בה כהסבר לכל דבר. ועדת סטרג'יס לא מצאה לה תמיכה ממשית ב-2015. המסקנה שלה הייתה פרוזאית הרבה יותר: המדגמים פשוט לא ייצגו היטב את ציבור הבוחרים. הם כללו יותר מדי מצביעי לייבור ופחות מדי מצביעים שמרנים, וגם השקלול שבוצע לאחר מכן לא הצליח לתקן את העיוות.
.
גם משאל העם על הברקזיט ב-2016 נכנס למיתולוגיה כ"כישלון הסקרים", אף שהסיפור מורכב יותר. הסקר האחרון של מכון Ipsos, שנערך יומיים לפני ההצבעה, נתן ל"הישארות" יתרון של 52 מול 48. התוצאה הסופית הייתה 51.9 אחוז ל"עזיבה" מול 48.1. אבל שבוע קודם לכן הסקר של אותו מכון עצמו הראה דווקא 53 אחוז ל"עזיבה", וסקרים רבים אחרים באותם שבועות נתנו ל"עזיבה" יתרון. ראש המחקר הפוליטי של Ipsos אמר ערב ההצבעה שלפי המודלים של המכון יש ל"עזיבה" סיכוי של אחד לארבעה לנצח. כלומר, חלק מההפתעה נוצר לא מהנתונים עצמם, אלא מהסיפור שהציבור והפרשנים בנו סביבם.
ואז הגיע טראמפ.
בחירות 2016 בארצות הברית היו הרגע שבו האמון הציבורי בסקרים נסדק, בצדק ושלא בצדק. אבל ועדת הבדיקה של האיגוד האמריקאי לחקר דעת קהל (AAPOR) הגיעה למסקנה שאינה מתיישבת עם הזיכרון הציבורי: הסקרים הארציים היו דווקא טובים למדי בהערכת הפער הארצי, והילרי קלינטון אכן קיבלה יותר קולות. הבעיה הגדולה הייתה בחלק מסקרי המדינות המתנדנדות, בעיקר במערב התיכון. הוועדה מצאה שתי סיבות עיקריות. הראשונה: מצביעים ללא השכלה אקדמית, שרבים מהם תמכו בטראמפ, היו בחסר במדגמים, ורוב הסוקרים במדינות לא תיקנו זאת. השנייה: כ-13 אחוז מהמצביעים בוויסקונסין, בפלורידה ובפנסילבניה החליטו בשבוע האחרון, והם נטו יותר לטראמפ. ל"מצביע טראמפ הביישן" לא נמצאה תמיכה של ממש.
אבל 2016 לימדה עוד שיעור, שאינו שייך לסטטיסטיקה אלא לדרך שבה המוח האנושי קורא מספרים. ערב הבחירות נתן אתר FiveThirtyEight של נייט סילבר להילרי קלינטון סיכוי של כ-71 אחוז לנצח, ולדונלד טראמפ כ-29 אחוז. אתרים אחרים היו בטוחים הרבה יותר, חלקם מעל 90 אחוז. אנשים רבים קראו את המספר של סילבר כאילו נאמר שקלינטון תקבל 71 אחוז מהקולות, או כאילו ניצחונה כמעט מובטח. אבל אירוע שמתרחש בהסתברות של 29 אחוז אינו נס. זה בערך הסיכוי שבהטלת קובייה יצא 1 או 2. מחקר מאוחר יותר של שון ווסטווד (Sean Westwood), סולומון מסינג (Solomon Messing) ויפתח לֶלקס (Yphtach Lelkes) מצא שאנשים אכן מתבלבלים בין הסתברות לנצח לבין אחוז הקולות, ושתחזיות הסתברותיות בטוחות עלולות אפילו להוריד את נכונותם של תומכי המועמד המוביל לטרוח ולהצביע. הבעיה לא הייתה רק המודל. היא הייתה השפה שבה הציבור למד לצרוך הסתברויות.
ב-2020 הגיעה סטירה נוספת. הפעם הסוקרים כבר הכירו את בעיית ההשכלה, וכמעט כולם תיקנו את המדגמים בהתאם. ובכל זאת, AAPOR מצא שסקרי הנשיאות הארציים רשמו את הטעות הגדולה ביותר זה ארבעים שנה, וסקרי המדינות את הגדולה ביותר זה עשרים שנה לפחות. בממוצע ניפחו הסקרים את הפער בין ג'ו ביידן לטראמפ בכ-3.9 נקודות ברמה הארצית ובכ-4.3 נקודות בסקרי המדינות. ביידן ניצח, אבל הפער היה קטן בהרבה מזה שעליו הצביעו הסקרים. הוועדה לא הצליחה לבודד גורם יחיד, אך אחת ההשערות שקיבלה תמיכה הייתה הטיית אי-מענה מפלגתית: האפשרות שתומכי טראמפ היו פחות נכונים להשתתף בסקרים. מחקרים מאוחרים יותר חיזקו את החשש הזה, וכיום Pew מצביע על ראיות מצטברות לכך שרפובליקנים אכן נוטים מעט פחות מדמוקרטים להשתתף בסקרים.
וזו אולי הבעיה המרתקת ביותר במקצוע הזה: הוא כל הזמן מתקן את המלחמה הקודמת.
אחרי 1948 למדו לא להפסיק לסקור מוקדם ועברו לדגימה הסתברותית. אחרי 2016 התחילו להקפיד על השכלה. אחרי 2020 גברה תשומת הלב להבדלים פוליטיים בעצם הנכונות להשתתף בסקר. בדו"ח חדש של Pew, שפורסם ב-16 בספטמבר 2026, מתברר שכמעט 70 אחוז מהסקרים הארציים בארצות הברית ב-2024 כבר שקללו את המדגם לפי הזדהות מפלגתית או לפי ההצבעה בבחירות קודמות, פרקטיקה שבעבר נחשבה שנויה במחלוקת. לפי Pew, בנתונים שלו שיפר תיקון כזה את הדיוק בנקודה-שתיים בממוצע לכל מועמד.
ב-2024 הסקרים האמריקאיים באמת השתפרו. ועדת הבדיקה של AAPOR קבעה בדיעבד שהם נתנו תמונה נכונה בעיקרה של מרוץ צמוד מאד. ועדיין נשארה הטיה מתונה באותו כיוון שנראה בשתי מערכות הבחירות הקודמות: הערכת יתר מסוימת של הצד הדמוקרטי. שלוש מערכות בחירות ברציפות, אותו כיוון. ההטיה קטנה, אבל היא עקבית. AAPOR עצמו לא ראה בכך ניצחון של שיטה אחת, והדגיש את הצורך להמשיך להתמודד עם אוכלוסיות שקשה להגיע אליהן, עם שקלול פוליטי ועם מודלים של שיעור הצבעה.
הסיבה נעשית ברורה כשמסתכלים על נתון אחד כמעט מפחיד.
ב-1997 שיעור ההיענות לסקרי הטלפון של Pew עמד על 36 אחוז. ב-2012 הוא כבר היה 9 אחוז. בשנים האחרונות הוא ירד לספרות בודדות נמוכות. בסקר טלפוני של הניו יורק טיימס ומכללת סיינה ב-2022 דווח אפילו על שיעור היענות של 0.4 אחוז: כדי להשיג תשובה אחת היה צריך לחייג למאתיים וחמישים מספרים. גם המעבר לאינטרנט אינו מעלים את הבעיה. כש-Pew מחשב את כל שרשרת הגיוס, ההצטרפות והנשירה של הפאנל המקוון שלו, שיעור ההשתתפות המצטבר עומד על כ-3 אחוזים.
זה לא אומר שסקר עם שיעור היענות של 3 אחוזים הוא בהכרח גרוע. מחקרים של Pew הראו שוב ושוב ששיעור היענות נמוך אינו הופך אוטומטית למדגם מוטה. אם שלושת האחוזים שמסכימים לענות דומים, אחרי תיקון, ל-97 האחוזים שאינם עונים בכל מה שחשוב לשאלה שלנו, הסקר עדיין יכול לעבוד. הבעיה מתחילה כשהסירוב עצמו קשור לפוליטיקה. אם תומכי מפלגה אחת, בעלי השכלה מסוימת, צעירים, חרדים, ערבים או כל קבוצה אחרת נוטים פחות לענות, אי אפשר לפתור את זה בהגדלת המדגם. מדגם גדול יותר של האנשים הלא נכונים הוא רק טעות גדולה יותר, וזה בדיוק מה שלימד אותנו הליטררי דייג'סט לפני תשעים שנה.
וכאן ישראל נעשית מקרה מבחן מרתק.
ב-1977 ערכה הטלוויזיה הישראלית בפעם הראשונה מדגם בחירות. ראש מחלקת החדשות, דן שילון, החליט לחקות את המדגמים של הטלוויזיה הבריטית, והסטטיסטיקאי חנוך סמית בנה את התחזית על בסיס 24 קלפיות מדגם. המדגם העניק לליכוד 44 מנדטים. אפילו אנשי רשות השידור התקשו בהתחלה להאמין למספרים. ואז הביט חיים יבין למצלמה ואמר את המילה שנכנסה לשפה העברית: "מהפך". הליכוד קיבל בפועל 43 מנדטים, והמערך 32, בדיוק כפי שחזה המדגם. מדגם קטן יחסית זיהה בזמן אמת את חילופי השלטון הראשונים בתולדות המדינה.
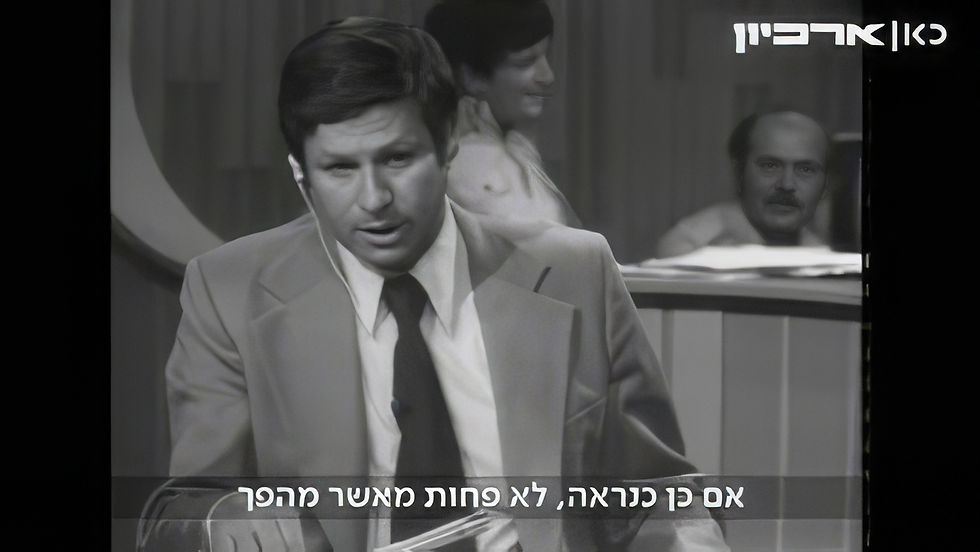
באותן שנים התחיל לצמוח בישראל מקצוע שלם. מינה צמח, שעמדה בראש מכון המחקר של משרד הפרסום "דחף", הפכה במשך עשורים לפרצוף של הסקרים בישראל, עד כדי כך שקמיל פוקס, המתחרה והעמית שלה, קרא לספר שכתב על עולם הסקרים "תשיגו לי את מינה צמח!". פוקס עצמו, פרופסור לסטטיסטיקה מאוניברסיטת תל אביב, היה במשך שנים הסוקר של ערוצי הטלוויזיה, עד מותו ב-2024. השניים ליוו את הציבור הישראלי בכל ליל בחירות, והיו גם הראשונים לספוג את האש כשהמספרים לא התאימו.
כבר ב-2003 הזהיר פוקס מפני מה שקרה אחר כך לכל העולם. "שלושה מתוך חמישה נשאלים מסרבים לענות", אמר על סקרי הטלפון, והסביר שבמצב כזה אלה שכן עונים "הופכים עצמם למדגם לא מייצג". באותה הזדמנות טבע גם מילה לתיאור התשוקה הישראלית לסקרים: "סקרת".
19 שנה אחרי המהפך הגיע ליל פרס-נתניהו. וב-2015 חזרה הדרמה בצורה אחרת. המדגמים של שלושת הערוצים בעשר בלילה הציגו מרוץ כמעט צמוד: בערוצים 1 ו-10 הליכוד והמחנה הציוני עמדו על 27 מנדטים כל אחד, ובערוץ 2 קיבל הליכוד 28 מול 27. כשהסתיימה הספירה עמד הליכוד על 30 והמחנה הציוני על 24. שלושה מדגמים שונים פספסו את אותו צד, באותו כיוון.
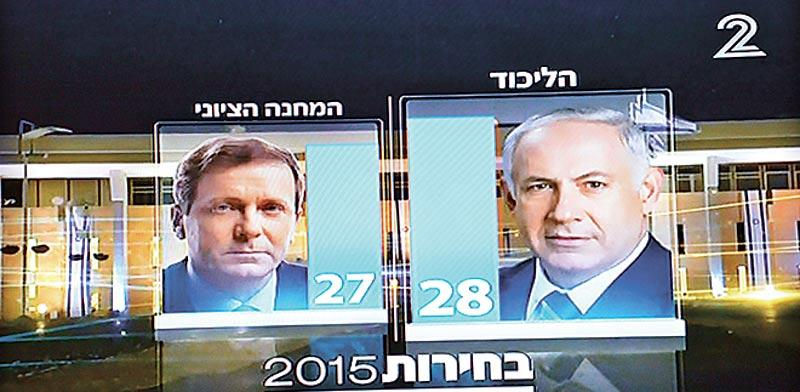
פוקס סיפר אחר כך שנודע לו על התוצאה בבוקר, משיחת טלפון של אשתו. "חשבתי שאני מת", אמר. אבל הוא לא הסתפק בתיאור ההלם, והציע שלושה הסברים. הראשון: במדגם שלו כ-30 אחוז מהנשאלים ביציאה מהקלפי סירבו לומר למי הצביעו, כפול מאשר במדגם של מינה צמח, והוא חשד שמצביעי ליכוד, שראו בתקשורת גוף עוין, סירבו יותר. השני: המדגמים נסגרו כבר ב-20:45, לפני סגירת הקלפיות, והחמיצו מצביעים שהגיעו מאוחר. השלישי היה הפשוט מכולם: "חלק מהאנשים לא אומרים את האמת, כלומר משקרים".
מפתה לקחת את המשפט הזה ולהכריז: "מצביעי ליכוד משקרים לסוקרים". אבל גם כאן כדאי להיזהר. ההסבר של פוקס עצמו מראה שהטעות נולדה מכמה דברים יחד: מי סירב, מתי נסגר המדגם, ומי הגיע לקלפי בשעות האחרונות. העובדה שהטעות חזרה בכמה מערכות בחירות, תמיד באותו כיוון, היא סיבה טובה לבדוק ולתקן. היא אינה רישיון להכריז מראש על "אפקט הבוחר הביישן" בכל בחירות.
ובישראל יש גם בעיות שאין כמעט בשום מקום אחר. הראשונה היא החברה הערבית. שיעור ההצבעה בה משתנה בחדות ממערכת למערכת: במרץ 2020 הצביעו 64.8 אחוז מבעלי זכות הבחירה הערבים, ושנה אחר כך, במרץ 2021, רק 44.6 אחוז. כשסוקר צריך לנחש אם שיעור ההצבעה יהיה 45 או 65 אחוז, כל הנחה כזאת מזיזה מנדטים שלמים, ולא רק במפלגות הערביות. זה משנה את כל המפה, כי כל קול שלא נספר משנה את "מחיר" המנדט לכל השאר. הבעיה השנייה היא החברה החרדית, שחלק גדול ממנה אינו גולש באינטרנט ואינו חבר בפאנלים המקוונים שעליהם נשענים היום רוב הסקרים. הסוקרים מתמודדים עם זה באמצעות מדגמים נפרדים ותיקונים סטטיסטיים. ההצבעה החרדית יציבה יחסית ולכן קלה יחסית לניבוי, אבל אם מישהו מנסה לזהות אצלה שינוי אמיתי, יכולת המדידה שלו נעשית מוגבלת בהרבה.
והבעיה הגדולה מכולן, זו שאין לבחירות לנשיאות: אחוז החסימה.
בבחירות לכנסת גם אי אפשר להמיר בפשטות את טעות הדגימה באחוזים לטעות במנדטים. היחס בין שיעור התמיכה למספר המושבים אינו ליניארי: הוא תלוי בין היתר באילו מפלגות עברו את אחוז החסימה, במספר הקולות שאינם משתתפים בחלוקה ובהסכמי העודפים. לכן אפילו שינוי קטן יחסית באחוזי התמיכה יכול, בתנאים מסוימים, לייצר שינוי גדול יותר במספר המנדטים.
בחירות 2022 הן הדוגמה כמעט המושלמת. מרצ קיבלה 150,793 קולות, 3.2 אחוזים, ולא נכנסה לכנסת. בל"ד קיבלה 138,617 קולות, 2.9 אחוזים, וגם היא נשארה בחוץ. שתי המפלגות לבדן צברו כמעט 290 אלף קולות שלא השתתפו בחלוקת המושבים. יחד עם יתר הרשימות שלא עברו את אחוז החסימה, הגיע מספר הקולות שלא השתתפו בחלוקה ל-417,400 - 8.76 אחוזים מכלל הקולות הכשרים. ובשעה שבמספר הקולות הכולל היו הגושים קרובים מאד זה לזה, חלוקת המנדטים העניקה 64 מושבים למפלגות שתמכו בנתניהו. והסקרים? ממוצע הסקרים בימים שלפני הבחירות קלע בטווח של מנדט אחד לרוב המפלגות. הוא פספס בגדול רק במקום אחד: מרצ, שקיבלה בו ארבעה מנדטים וקיבלה בפועל אפס. זו לא הייתה טעות מדידה דרמטית. זה היה הבדל של עשיריות אחוז, שהמערכת תרגמה לארבעה מנדטים.
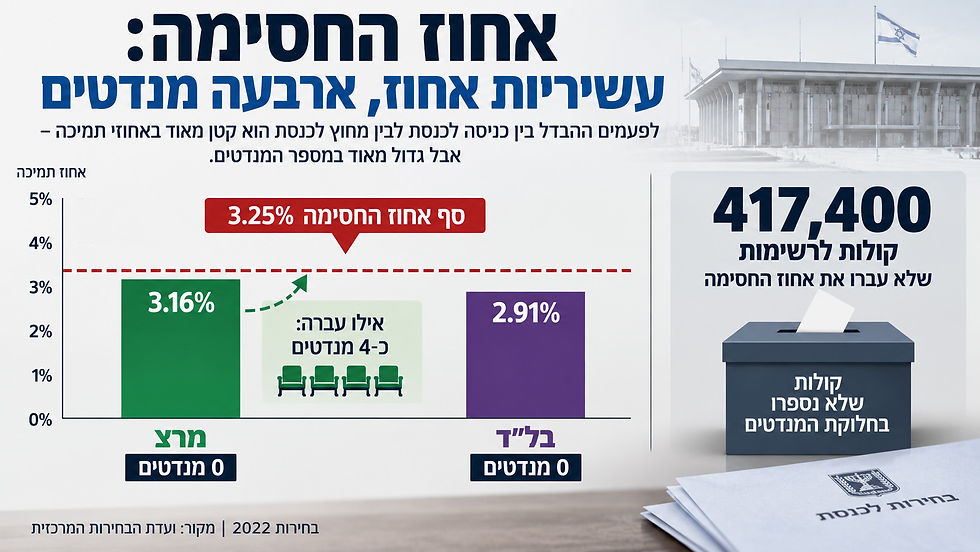
עכשיו נניח שסקר אחד מציב מפלגה על 3.1 אחוזים וסקר אחר על 3.4. הפער ביניהם הוא שלוש עשיריות האחוז בלבד, הרבה פחות מטעות הדגימה הרגילה. אבל במודל המנדטים ההבדל יכול להיות בין אפס לבין ארבעה מושבים, ובמקביל להשפיע על כל שאר המפלגות, כי הקולות נכנסים מחדש לחלוקה. לכן המשפט "המפלגה התחזקה בארבעה מנדטים" יכול לפעמים לתאר שינוי זעיר מאד באחוזי התמיכה, ולא גל ציבורי עצום.
ואז מגיעה מערכת הבחירות הנוכחית, שמספקת כמעט ניסוי חי בשאלה מהו בכלל סקר.
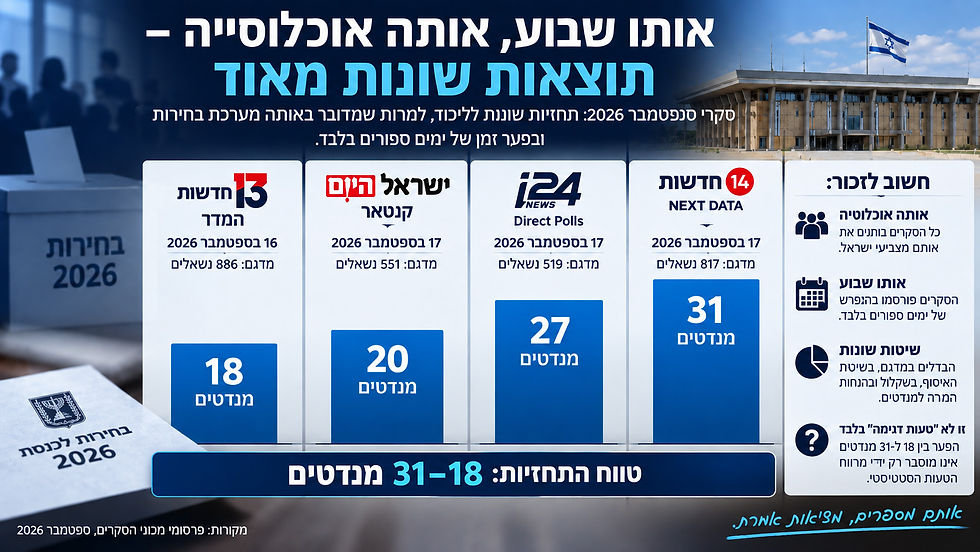
באמצע ספטמבר 2026 פורסמו בתוך ימים ספורים תוצאות שקשה ליישב זו עם זו באמצעות טעות דגימה בלבד. בסקר של חדשות 14 ומכון NEXT DATA מ-17 בספטמבר קיבל הליכוד 31 מנדטים ומפלגת ישר בראשות גדי איזנקוט 20, והגוש שהערוץ הגדיר כ"גוש הימין" קיבל 64. בסקר השתתפו 817 משיבים, וניתוח הנתונים נעשה בידי שלמה פילבר.
שלושה ימים קודם לכן, בסקר של חדשות 12 שערך מכון מדגם בראשות מנו גבע, קיבל הליכוד 20 מנדטים וישר 23. השתתפו בו 502 משיבים מתוך 2,514 שהתבקשו להשתתף, והוא נערך באינטרנט ובטלפון. טעות הדגימה המרבית שפורסמה הייתה 4.4 אחוזים. בסקר של ישראל היום ומכון קנטאר, שנערך ב-16 וב-17 בספטמבר בקרב 551 משיבים, עמדה ישר על 22 והליכוד על 20, עם טעות דגימה מרבית של 4.2 אחוזים.
אין צורך לבחור כאן מי צודק, ובוודאי אי אפשר לדעת זאת לפני ההצבעה. דווקא הפער הוא הסיפור. כשמכון אחד מתרגם את הנתונים ל-31 מנדטים לליכוד ומכונים אחרים באותו שבוע מגיעים לכ-20, ברור שלא נכון להסביר את הפער רק באמצעות המספר ‘±4.4%’ שמופיע בתחתית אחד הסקרים. ממילא אלה אינן אותן יחידות: מרווח הטעות מתייחס לאחוזי התמיכה במדגם, ואילו מספר המנדטים הוא תוצאה של המרה נוספת התלויה גם באחוז החסימה ובחלוקת הקולות. הפערים הרחבים בין תחזיות המנדטים מלמדים שיש הבדלים נוספים בין הסקרים - במדגם, בשיטת האיסוף, בשקלול, בהנחות על השתתפות ובמודל שממיר אחוזים למושבים.
ולכן השאלה "מי עשה את הסקר?" אינה רכילות. היא חלק מהנתון.
לסוקרים יש מה שמכונה "אפקט בית" (house effect): נטייה עקבית שנובעת מהשיטה שלהם. שני מכונים יכולים לעבוד ביושר מלא ולקבל תוצאות שונות, כי אחד משתמש יותר בטלפון והשני בפאנל אינטרנטי, אחד משקלל לפי הצבעה קודמת והשני לא, אחד מניח שיעור השתתפות מסוים לקבוצה מסוימת והשני מניח אחר. כשההבדל חוזר מסקר לסקר, הוא עצמו הופך למידע שצריך להבין. ובאותה מידה לגיטימי לשאול מי עומד מאחורי כל מכון. פילבר, למשל, שימש בעבר מנכ"ל משרד התקשורת בממשלת נתניהו. זה אינו מוכיח שהסקרים שלו שגויים. זה כן אומר שהקורא זכאי לדעת את זה, בדיוק כפי שהוא זכאי לדעת את גודל המדגם.
החוק הישראלי מכיר בכך. מי שמפרסם סקר בחירות נדרש למסור, בין היתר, מי הזמין אותו, מי ערך אותו, מתי נערך, מהי אוכלוסיית המחקר, כמה אנשים התבקשו להשתתף וכמה השתתפו בפועל, ומהי טעות הדגימה. עורך הסקר נדרש להעביר לוועדת הבחירות המרכזית גם מידע מפורט יותר על שיטת הדגימה ואיסוף הנתונים, ולשמור את הנתונים שנים אחרי הבחירות. התכלית ברורה: לא מספיק שהציבור יראה את המספר. הוא צריך אפשרות לשפוט איך נולד המספר.
החוק גם אוסר לפרסם תוצאות של סקר בחירות חדש מתום יום שישי שלפני הבחירות ועד לסגירת הקלפיות ביום הבחירות, שיחולו ביום שלישי. כך נוצר בישראל מצב מוזר למדי: דווקא בימים שבהם ייתכן שמתרחשים השינויים האחרונים בדעת הקהל, הציבור מפסיק לקבל מדידות חדשות. ומי שזוכר את טרומן ודיואי ב-1948, יודע כמה יכול לקרות בימים האחרונים.
מה עושים הסוקרים כשהם יודעים שהמדגם שלהם אינו נראה כמו המדינה? הם משקללים אותו.
נניח שבמדגם יש יותר מדי בני 65 ומעלה ופחות מדי צעירים. הפתרון אינו לזרוק את הסקר לפח, אלא לתת לכל צעיר שהשתתף משקל מעט גדול יותר ולכל מבוגר משקל מעט קטן יותר, עד שהמדגם מתקרב להרכב האוכלוסייה. אותו דבר אפשר לעשות לפי מין, אזור מגורים, השכלה, דת, ולעתים גם לפי משתנים פוליטיים.
זה נשמע כמעט כמו מניפולציה, אבל בלי שקלול רוב הסקרים המודרניים היו גרועים בהרבה. הקושי מתחיל בשאלה לפי מה לשקלל. את הרכב הגילים והמינים אפשר לקבל מנתונים חיצוניים אמינים, כמו אלה של הלמ"ס. אבל מהו "האחוז הנכון" של מצביעי ליכוד בחודש שלפני הבחירות? אם מכריחים את המדגם להתאים למספר מסוים, אפשר להשתיק שינוי פוליטי אמיתי. אם לא מתקנים בכלל, ייתכן שמדדת רק מי אוהב לענות לסקרים.
מרכז המחקר Pew מתאר בדיוק את הדילמה הזאת בדו"ח החדש שלו. בארצות הברית מצטברות ראיות שרפובליקנים מעט פחות נכונים מדמוקרטים להשתתף בסקרים, ולכן יותר ויותר מכונים משתמשים בהצבעה קודמת או בהזדהות מפלגתית כעוגן. אבל Pew מדגיש שאין שיטת שקלול פוליטית אחת שהיא הטובה ביותר בכל מצב, ושגם מדגם שמכיל את שיעור הרפובליקנים "הנכון" אינו בהכרח מודד נכון את התמיכה במועמד מסוים.
הטכנולוגיה רק מסבכת את העניין. פעם התקשרו לטלפון הקווי. אחר כך נכנס הסלולרי. היום חלק גדול מהסקרים נשען על פאנלים מקוונים של אנשים שהסכימו מראש לקבל שאלונים. לכל שיטה יתרונות וחסרונות. שיחה עם מראיין יכולה להגיע לאנשים שאינם חברים בשום פאנל, אבל היא עלולה להפעיל לחץ חברתי: קשה יותר לומר לאדם אחר שאתה מצביע למפלגה לא פופולרית. שאלון אינטרנטי נותן אנונימיות רבה יותר, אבל מי שהצטרף לפאנל אינטרנטי מלכתחילה אינו דגימה אקראית של הציבור. סקר טלפוני אוטומטי, שבו הקלטה שואלת ומקישים על המקשים, פותר את בעיית המראיין אבל יוצר בעיות כיסוי אחרות.
ולכן סקר מודרני הוא כבר לא רק "שאלנו 500 אנשים". הוא תוצר של שרשרת: מי יכול היה להיבחר, מי קיבל הזמנה, מי ענה, איך נשאל, איזה משקל קיבל כל אחד, מי הוגדר כמי שיגיע לקלפי, איך טופלו המתלבטים, ואיך האחוזים הומרו למנדטים. כל חוליה בשרשרת הזאת היא החלטה של בני אדם.
היו שניסו לברוח מהבעיות האלה בעזרת מודלים מורכבים יותר. אחד הכלים המעניינים הוא MRP, ראשי תיבות של Multilevel Regression and Post-stratification. במקום לחפש מאות נשאלים בכל אזור בחירה, לוקחים מדגם ארצי גדול, לומדים ממנו איך קבוצות דמוגרפיות וגיאוגרפיות שונות נוטות להצביע, ואז מחילים את הדפוסים האלה על ההרכב הידוע של כל אזור. ב-2017 חזה מודל MRP של מכון YouGov, שנבנה עם חוקרים מבית הספר לכלכלה של לונדון (LSE), שהבחירות בבריטניה יסתיימו בפרלמנט ללא רוב, בזמן שרוב התחזיות האחרות צפו רוב שמרני. הוא צדק. אבל גם אנשי YouGov הזכירו אז שמודל אינו נביא: הוא מעריך מה היה קורה אילו הבחירות נערכו היום, על סמך הנתונים שיש עכשיו.
אפילו בינה מלאכותית כבר נכנסת לתמונה. חוקרים משתמשים במודלי שפה כדי לנסח שאלונים, לנהל ראיונות ולנתח תשובות פתוחות, ויש גם ניסיונות להשתמש ב"משיבים סינתטיים": לבקש ממודל שפה לענות על סקר כאילו היה בוחר בן 45 מחולון עם תואר ראשון. זה מבטיח לחסוך הרבה כסף. אבל נכון ל-2026 אין ראיה משכנעת שמשיבים כאלה יכולים להחליף בני אדם בסקרי בחירות, והסיבה פשוטה: מודל שפה יכול לשחזר דפוסים שלמד ואף להסיק מהם מסקנות חדשות, אבל אין לנו בסיס להניח שהתשובות הסינתטיות שלו מייצגות שינוי אמיתי שמתרחש עכשיו בציבור. אם הבוחרים שינו את דעתם הבוקר, הדרך הבטוחה ביותר לגלות זאת עדיין מתחילה בלשאול בני אדם אמיתיים.
בשנים האחרונות נכנס לזירה מתחרה חדש: שווקי חיזוי כמו פולימרקט ו-Kalshi. במקום לשאול "למי תצביע?", הם שואלים למעשה "על איזה תרחיש אתה מוכן לשים כסף?". בבחירות בארצות הברית ב-2024 הוזרמו אליהם מיליארדי דולרים, והם נראו בדיעבד מרשימים במיוחד. אבל מחקר מאוחר יותר של ג'וש קלינטון (Joshua Clinton) וטסו-פנג הואנג (TzuFeng Huang) מאוניברסיטת ונדרבילט, שבחן יותר מ-2,500 שווקים, מצא תמונה פחות זוהרת: הדיוק השתנה מאד בין הפלטפורמות, הופיעו פערי מחירים שלא נסגרו, ורבים מהשווקים הקטנים היו רחוקים מלהיות "מכונת אמת".
וזה הגיוני. סקר ושוק חיזוי מודדים שני דברים שונים. הסקר מנסה למדוד את הבוחרים. השוק מודד מה הסוחרים חושבים שיקרה. אם אלף סוחרים קוראים את אותם עשרים סקרים ואז מהמרים לפיהם, לא קיבלנו אלף מדידות חדשות של הציבור. קיבלנו אלף פרשנויות לאותם עשרים סקרים.
סקר שנערך ביום ראשון אינו יכול לדעת מה יקרה ביום חמישי. מועמד יכול למעוד בעימות. מלחמה יכולה לפרוץ. תיק חקירה יכול להיפתח. מפלגה יכולה לפרוש. סרטון יכול להפוך לוויראלי. אנשים שהתכוונו להצביע יכולים להישאר בבית, ואנשים שלא התכוונו יכולים להתייצב בקלפי. הסקר אינו טועה כשהעתיד שונה מההווה. אנחנו טועים כשאנחנו מבקשים ממנו למדוד משהו שהוא מעולם לא מדד.
זו אולי הדרך הנכונה לקרוא את הסקרים בחודש שנותר עד הבחירות.
לא לשאול רק מי עלה בשני מנדטים מאז יום שני. לבדוק מתי נערך הסקר, כמה אנשים השתתפו וכמה התבקשו ולא ענו. האם הוא טלפוני, אינטרנטי או משולב. מי הזמין אותו ומי ערך אותו. מה קורה למפלגות שמסביב ל-3.25 אחוז. האם שינוי במנדטים נובע משינוי אמיתי בתמיכה, או רק מכך שמפלגה אחת חצתה במודל את אחוז החסימה. ובעיקר, להשוות בין כמה מכונים לאורך זמן, במקום להתאהב בסקר היחיד שאומר לנו את מה שרצינו לשמוע. כי זו האמת המוזרה על סקרים: הם יכולים להיות בו-זמנית כלי מדעי רציני ומספר לא מדויק בעליל.
מאה שנות סקרים לימדו את המקצוע ענווה, וכמעט כל שיעור נלמד בליל בחירות אחד, מול מספרים שלא התאימו. הליטררי דייג'סט גילה שמיליוני תשובות לא יצילו מדגם מוטה, וגאלופ גילה ב-1948 שסקר מצוין שנסגר מוקדם מדי אינו יודע מה יקרה אחריו. פרס ונתניהו הראו שבמרוץ של פחות מאחוז, סטייה זעירה מחליפה את שם ראש הממשלה, וקמיל פוקס, בבוקר שאחרי 2015, גילה ששלושה מדגמים יכולים לטעות יחד באותו כיוון. ואם 2020 לימדה משהו, זה שגם אחרי שתיקנת את השגיאה הקודמת, מחכה לך שגיאה חדשה.
ועכשיו, ב-2026, אנחנו מקבלים בישראל שיעור נוסף בזמן אמת: באותה מדינה, באותו שבוע, קבוצות שונות של חוקרים יכולות לקחת כמה מאות אזרחים, להעביר אותם דרך מודלים שונים, ולהגיע לתמונות פוליטיות שונות מאד. אחרי הבחירות יהיה קל לבדוק מי היה קרוב יותר.
השאלה המעניינת באמת היא מה נעשה עם הסקרים לפני שנדע.
אם נקרא אותם כנבואה, כמעט מובטח שבשלב כלשהו נתאכזב. אם נקרא אותם כמדידה, עם טווח, שיטה, הטיות, הנחות ותאריך תפוגה, הם הופכים למשהו שימושי בהרבה. הם לא יגידו לנו מי ינצח, אבל יאפשרו לראות, באופן חלקי ולא מושלם, איך ציבור של מיליוני בני אדם נע בתוך מערכת בחירות.
ובסופו של דבר, אולי זו השאלה שכדאי לשאול בכל פעם שמופיעה על המסך עוד כותרת של "דרמה בסקרים".
לא: מה אומר המספר?
אלא: מה היה צריך להיות נכון כדי שהמספר הזה יהיה נכון?
מקורות:
Pew Research Center, "Understanding the margin of error in election polls", 8.9.2016
AAPOR (2017). An Evaluation of 2016 Election Polls in the U.S
Pew Research Center, "Weighting Polls on Party Affiliation and Past Vote", 16.9.2026
Pew Research Center, "Pollsters face challenges in getting survey respondents", 24.5.2012
"How YouGov correctly predicted the UK election where other pollsters failed", Computerworld
Tasha Kheiriddin, Are prediction markets the new polls? Yahoo News
"מדגמי הבחירות מול תוצאות האמת: מתי הם קלעו בול - ומתי פספסו?", ynet
"קמיל פוקס על כישלון המדגמים: 'כשסיפרו לי על התוצאות, חשבתי שאני מת'", TheMarker, 18.3.2015
"הצבעת האזרחים הערבים בבחירות לכנסת ה-24, מרץ 2021", המכון הישראלי לדמוקרטיה.
"The 2022 Elections: Results Analysis", Israel Democracy Institute.
הערה על אימות
הנתונים המרכזיים נבדקו מול מקורות ראשוניים או מול דיווחים מקוריים. אלה כוללים את תוצאות 1996 ו-2015 מול המדגמים, דבריו של קמיל פוקס (TheMarker ו-ynet), ניתוח הליטררי דייג'סט (סקווייר 1988), דו"חות AAPOR ל-2016 ול-2020, הסקר האחרון של Ipsos בברקזיט, שיעורי ההצבעה בחברה הערבית (המכון הישראלי לדמוקרטיה), ושלושת סקרי ספטמבר 2026 מול אתרי הגופים שפרסמו אותם. הקביעה שהטעות בפועל כפולה מטעות הדגימה המדווחת נשענת על מחקר אחד, רחב (Shirani-Mehr ועמיתיו), שבחן בחירות בארצות הברית בשנים 1998-2014. היא אינה בהכרח חלה כמות שהיא על ישראל. גודל המדגם בסקר קנטאר (551) נלקח מהדיווח. הוא תואם את טעות הדגימה שפורסמה (4.2%), אבל כדאי לוודא אותו מול הכתבה. נתוני הסקרים של 2026 הם תמונת מצב של אמצע ספטמבר וישתנו עד הבחירות.



תגובות